El Dilema del Desarrollador Impaciente
Este escenario se repite muchas veces: un desarrollador diseña un procedimiento para actualizar 100,000 registros. La lógica parece impecable: abrir un cursor, iterar fila por fila y ejecutar un UPDATE. Sin embargo, en producción, el proceso se arrastra. Lo que sobre el papel es una integración "transparente" entre el lenguaje procedimental y los datos, en la práctica se convierte en un cuello de botella que asfixia el rendimiento del sistema.
Muchos profesionales caen en la trampa de escribir código que funciona bien en entornos de desarrollo con pocos registros, pero que agoniza ante volúmenes masivos. El problema no suele ser la potencia del hardware ni la complejidad del dato, sino la fricción arquitectónica. Si quieres dejar de escribir código "amateur" y empezar a construir soluciones de alto impacto, es hora de analizar qué sucede realmente bajo el capó del motor Oracle.
1. Lo prohibido: "Registro-por-registro = Lento-por-Lento"
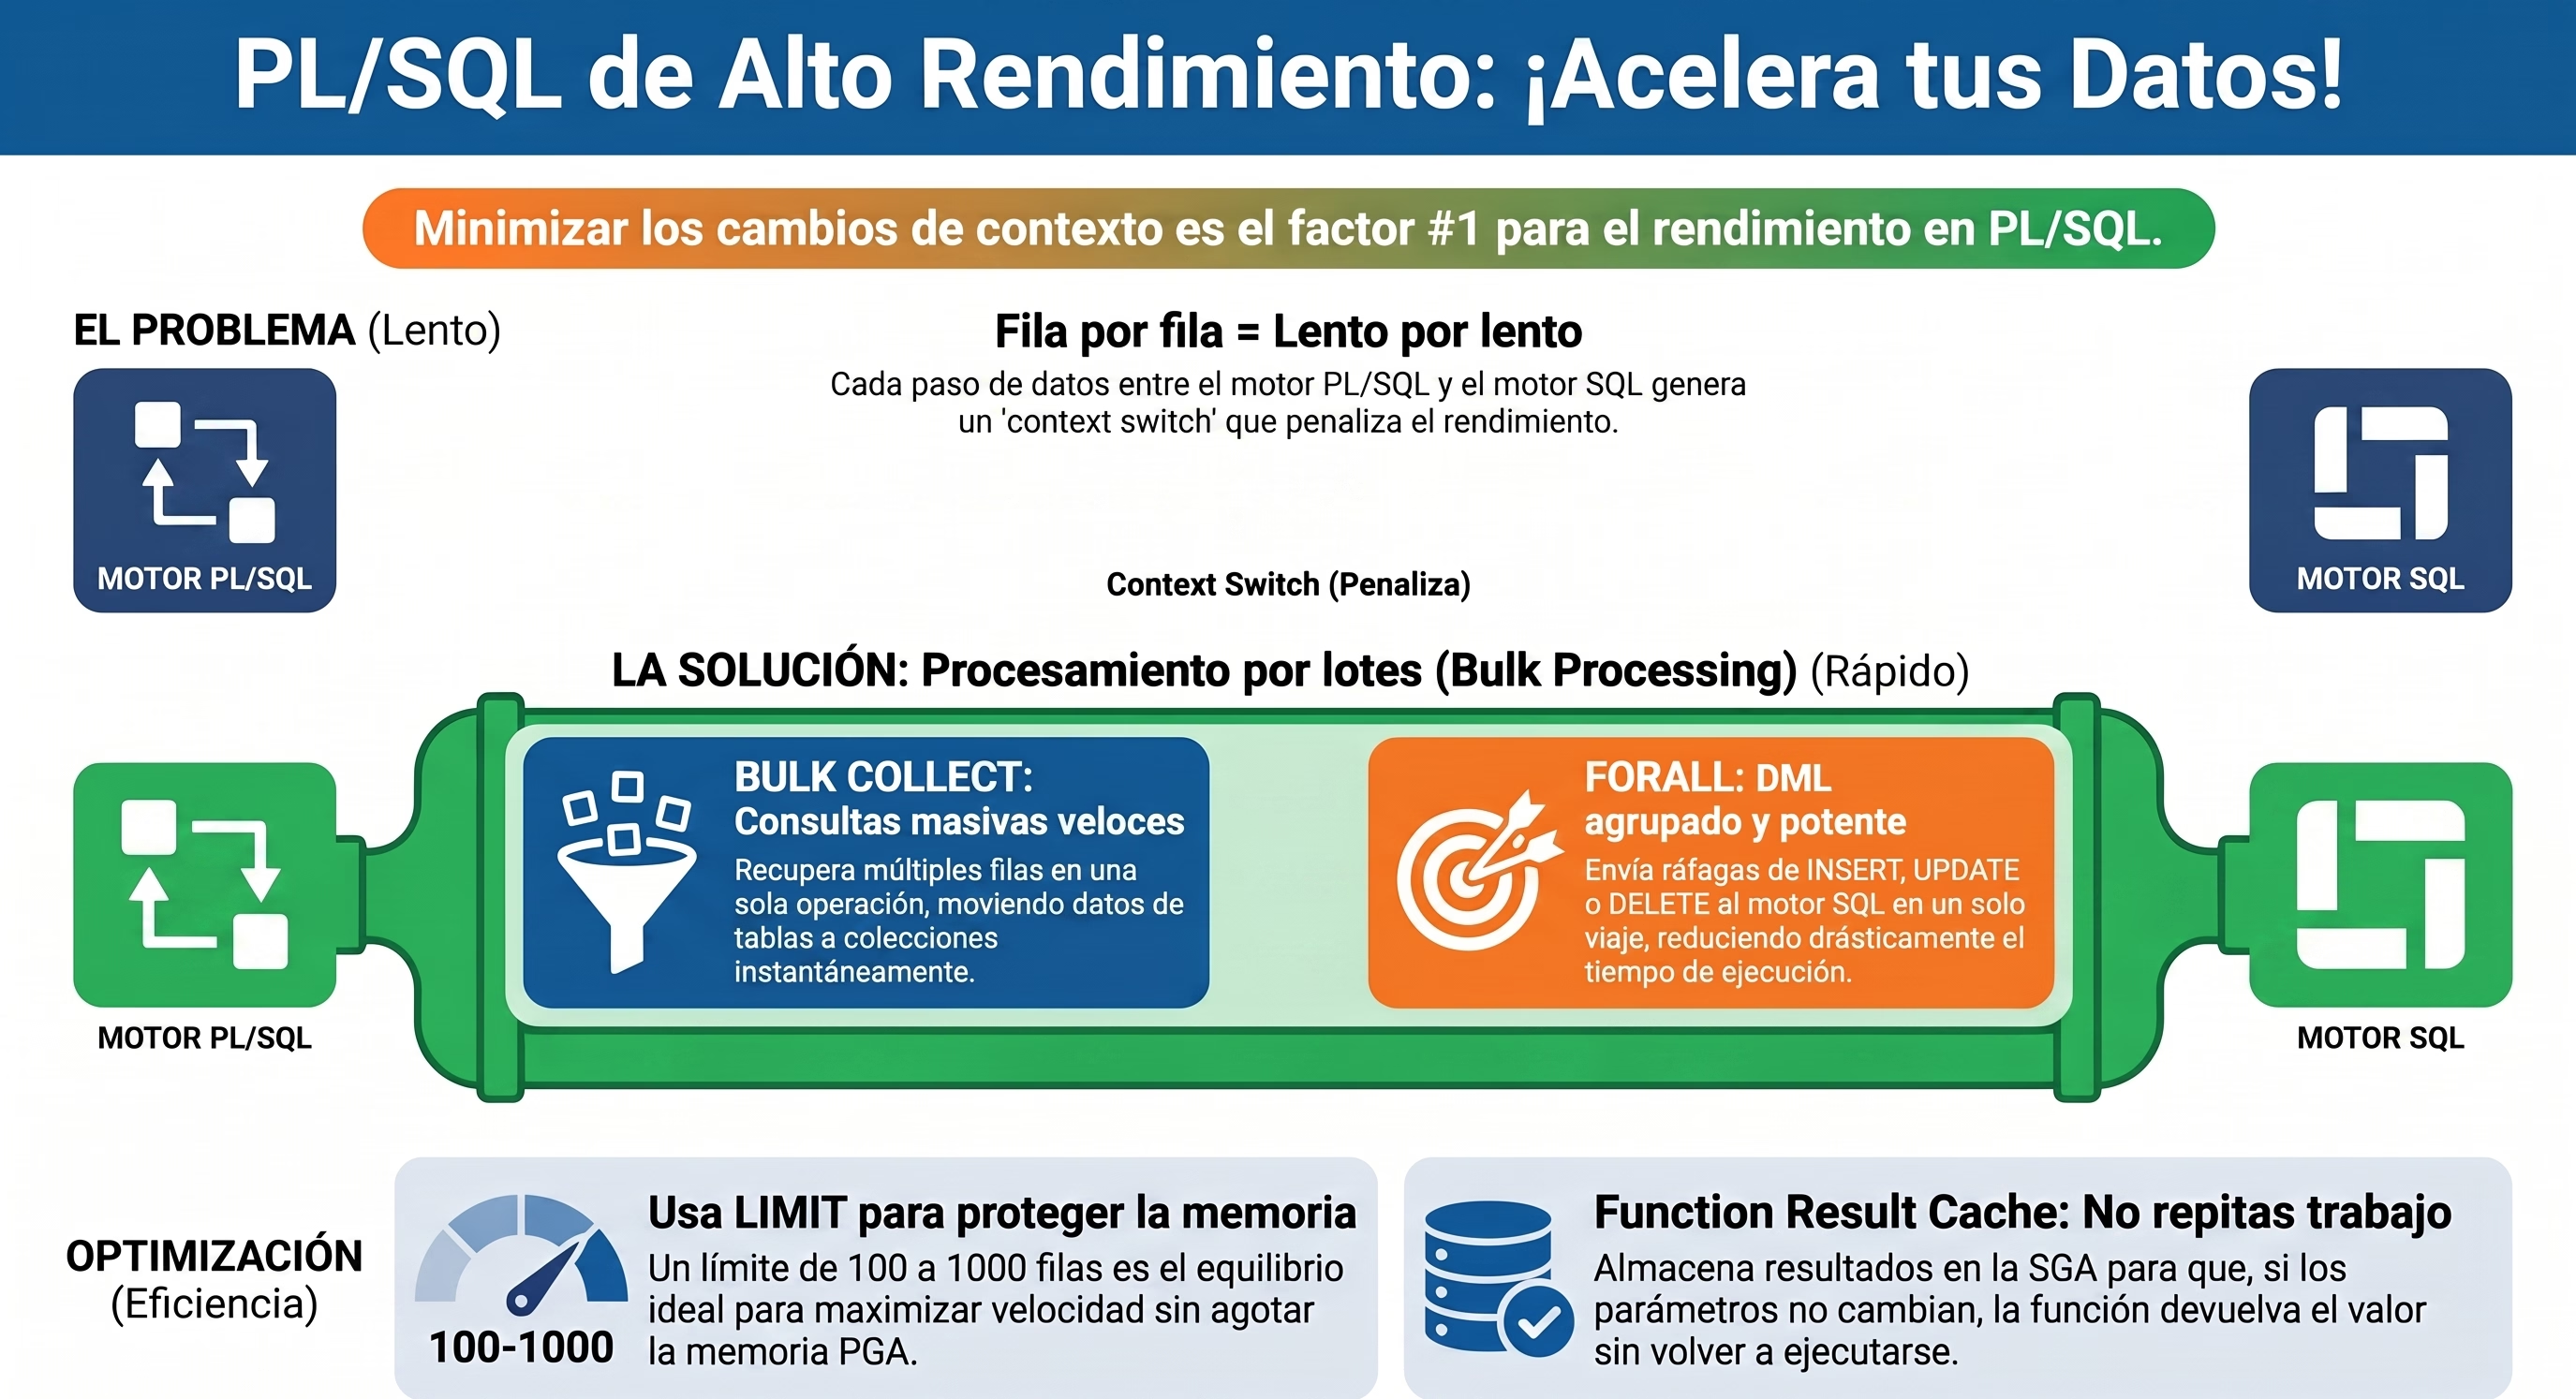
El procesamiento fila por fila es el anti patrón por excelencia en PL/SQL. Los desarrolladores suelen refugiarse en este enfoque porque imita la programación imperativa tradicional, pero en una base de datos relacional, esta es la ruta más rápida hacia la ineficiencia. Se recupera una fila, se procesa, se envía de vuelta; un ciclo infinito de desperdicio de recursos.
La trampa reside en la aparente sencillez de la integración entre SQL y PL/SQL. Parece que ambos motores hablan el mismo idioma, pero la realidad es que cada interacción individual tiene un costo de ejecución que, sumado miles de veces, resulta prohibitivo.
2. El peaje invisible: Los "Context Switches"
Para optimizar, primero debemos entender la anatomía de la ejecución. Dentro del servidor Oracle conviven dos entidades distintas: el PL/SQL Runtime Engine (que procesa la lógica y el control) y el SQL Engine (el músculo que maneja los datos).
Cada vez que un bloque PL/SQL encuentra una sentencia SQL, debe detenerse y pasar el control al motor de SQL. A esto lo llamamos "context switch" (cambio de contexto). Imagina que estas interacciones son "viajes innecesarios a la frontera" entre dos países. Si tienes 100,000 personas y cruzas la frontera 100,000 veces para sellar cada pasaporte individualmente, perderás el día entero en trámites migratorios. El rendimiento se penaliza por la frecuencia de estos intercambios, no por el peso de la maleta que llevas.
3. El arma definitiva: FORALL y BULK COLLECT
Si me preguntas cuál es la herramienta más importante en el arsenal de un arquitecto para el ajuste de rendimiento, la respuesta es clara: Bulk Processing. El objetivo es reducir drásticamente los cambios de contexto "empaquetando" (bundling up) las solicitudes en una sola operación masiva.
- FORALL: Es, sencillamente, la característica de tunning más vital de PL/SQL. En lugar de ejecutar múltiples DMLs (INSERT, UPDATE, DELETE, MERGE) individualmente, utilizamos binding arrays para enviar todas las peticiones al motor SQL de un solo golpe.
- BULK COLLECT: Es la contraparte para consultas. Permite depositar múltiples filas de datos directamente en colecciones (memoria) con un solo cambio de contexto.
FORALL para sentencias INSERT, los disparadores (triggers) a nivel de sentencia (BEFORE y AFTER STATEMENT) solo se activan una vez, sin importar si estás insertando diez o diez mil registros. Esto reduce significativamente el overhead en la capa de datos.
4. Gestión de memoria: El arte del LIMIT
Poder no es sinónimo de imprudencia. Usar un BULK COLLECT sin restricciones en una tabla de millones de filas es una receta para el desastre: saturarás la PGA (Program Global Area) y provocarás errores de memoria. En aplicaciones de producción, el uso de la cláusula LIMIT es innegociable.
Sabiduría de Arquitecto:
- El Estándar: Un
LIMIT 100suele ser el valor predeterminado ideal. Ofrece un equilibrio perfecto entre reducción de cambios de contexto y consumo de memoria. - La Excepción: Aumentar el límite a 500 o 1000 rara vez ofrece una mejora proporcional. Sin embargo, si manejas volúmenes masivos de datos con un número muy reducido de procesos batch, un
LIMITmayor podría darte ese último empujón de velocidad necesario. Mi consejo: pasa el valor del límite como un parámetro para mantener la flexibilidad de tu arquitectura.
5. El secreto: Function Result Cache
¿Y si te dijera que la mejor forma de optimizar una función es no ejecutarla? Al añadir la cláusula RESULT_CACHE, Oracle almacena el resultado de la función en la SGA (Shared Global Area), lo que la hace compartida entre todas las sesiones del servidor.
La revelación técnica aquí es masiva: acceder al caché de resultados omite por completo el motor SQL. Es incluso más rápido que una consulta ya parseada y con sus bloques de datos en memoria, porque Oracle simplemente compara los parámetros de entrada y devuelve el valor almacenado.
Este caché es "inteligente": si los datos de las tablas de las que depende la función cambian y se hace un commit, Oracle invalida el caché automáticamente para prevenir datos inconsistentes. Es una ganancia de rendimiento explosiva con un cambio de código prácticamente nulo.
6. Bonus: Deja que el optimizador trabaje por ti
Desde Oracle 10g, el optimizador ha sido programado para ser más astuto que el desarrollador promedio. Si tienes bucles FOR de cursores simples que solo leen datos (sin DML dentro), el optimizador los transforma automáticamente para que realicen un fetching de 100 filas, emulando la eficiencia de un BULK COLLECT.
Consejo estratégico: No pierdas tiempo reescribiendo código antiguo que solo consulta datos si ya es "suficientemente rápido". Si el bucle no contiene operaciones de escritura, el optimizador probablemente ya está mitigando el costo de ejecución por ti. Enfoca tu energía en las operaciones DML pesadas.
Hacia un código de alto impacto
Optimizar PL/SQL es, en esencia, un intercambio estratégico: aceptamos una complejidad ligeramente mayor al manejar colecciones a cambio de una ejecución órdenes de magnitud más rápida. Como arquitectos, nuestra misión es eliminar la fricción y asegurar que el motor de la base de datos trabaje a su máxima capacidad.
Antes de cerrar tu IDE hoy, analiza tu proceso de carga de datos más crítico y hazte una pregunta: "¿Cuántos context switches podría eliminar hoy mismo con una sola línea de código?" Suena a magia, pero es simplemente ingeniería de alto nivel.
Vamos a la práctica
1. BULK COLLECT: Extracción de Datos a Alta Velocidad
BULK COLLECT permite recuperar múltiples filas de una consulta y depositarlas en una o más colecciones mediante un único fetch.
Implementación con Cursor Implícito
Es la forma más sencilla de cargar todos los resultados en una tabla anidada de una sola vez.
DECLARE
  TYPE t_empleados IS TABLE OF empleados%ROWTYPE;
  l_empleados t_empleados;
BEGIN
  -- Recuperación masiva total
  SELECT * BULK COLLECT INTO l_empleados FROM empleados;

  FOR i IN 1 .. l_empleados.COUNT LOOP
    procesar_empleado(l_empleados(i));
  END LOOP;
END;Mejor Práctica: El uso de la cláusula LIMIT
En entornos de producción, lo recomendable es procesar los datos en "lotes" controlados (por ejemplo, de 100 o 1000 filas) para gestionar eficientemente la memoria.
DECLARE
  CURSOR c_empleados IS SELECT * FROM empleados;
  TYPE t_empleados IS TABLE OF c_empleados%ROWTYPE;
  l_empleados t_empleados;
BEGIN
  OPEN c_empleados;
  LOOP
    -- Recupera hasta 1000 filas por ciclo
    FETCH c_empleados BULK COLLECT INTO l_empleados LIMIT 1000;
    EXIT WHEN l_empleados.COUNT = 0; -- Salida si no hay más datos

    procesar_lote(l_empleados);
  END LOOP;
  CLOSE c_empleados;
END;
2. FORALL: Operaciones DML Masivas
Mientras que BULK COLLECT optimiza las consultas, FORALL es la herramienta clave para acelerar operaciones de inserción, actualización, borrado y fusión (MERGE). En lugar de ejecutar un INSERT dentro de un bucle LOOP tradicional, PL/SQL envía todas las peticiones al motor SQL de una sola vez.
Ejemplo de Actualización con SAVE EXCEPTIONS
Por defecto, si un DML falla dentro de un procesamiento masivo, toda la operación se detiene. Al añadir SAVE EXCEPTIONS, permitimos que el motor continúe procesando el resto de las filas, guardando los errores en el atributo SQL%BULK_EXCEPTIONS.
DECLARE
  errores_masivos EXCEPTION;
  PRAGMA EXCEPTION_INIT(errores_masivos, -24381); -- Código de error masivo
BEGIN
  FORALL i IN l_lista_empleados.FIRST .. l_lista_empleados.LAST SAVE EXCEPTIONS
    UPDATE empleados
    SET salario = v_nuevo_salario
    WHERE empleado_id = l_lista_empleados(i);

EXCEPTION
  WHEN errores_masivos THEN
    -- Iteración sobre la pseudo-colección de errores
    FOR i IN 1 .. SQL%BULK_EXCEPTIONS.COUNT LOOP
      DBMS_OUTPUT.PUT_LINE('Error en índice: ' || SQL%BULK_EXCEPTIONS(i).ERROR_INDEX
                            || ' Código: ' || SQL%BULK_EXCEPTIONS(i).ERROR_CODE);
    END LOOP;
END;
3. El Enfoque por Fases (Phased Approach)
Para maximizar el rendimiento en procesos complejos, las fuentes sugieren pasar de un enfoque integrado fila por fila a uno dividido en fases:
- Fase 1 (Obtener Datos - Get Data): Uso de
BULK COLLECTpara mover datos de tablas a colecciones. - Fase 2 (Transformar Datos - Massage Data): Modificación del contenido de la colección en memoria según los requisitos de negocio.
- Fase 3 (Enviar Datos - Push Data): Uso de
FORALLpara persistir los cambios masivamente desde la colección hacia la tabla final.
Conclusión Técnica
El procesamiento masivo es, posiblemente, la característica de ajuste de rendimiento más importante de PL/SQL. Aunque aumenta ligeramente la complejidad del código, el beneficio es una ejecución dramáticamente más rápida al minimizar los cambios de contexto.
Pregunta para reflexionar: Si el optimizador de Oracle ya mejora automáticamente los bucles FOR de solo lectura desde la versión 10g, ¿estás aprovechando FORALL en tus operaciones DML, donde el impacto de rendimiento es aún mayor?